
So verhindern Sie doppelte Datenpflege sofort: eine zentrale Datenquelle (Single Source of Truth), Validierung vor dem Speichern und eindeutige IDs über alle Systeme hinweg. Das ist die Kernmaßnahme, alles andere ist Feinschliff.
Wer diesen dreiteiligen Ansatz umsetzt, unterbricht die Kette, die zu Dubletten führt, direkt an der Wurzel. Für Unternehmen, die Redundanzen bei Datensätzen proaktiv verhindern wollen, gilt die Kombination aus Master Data Management und systemübergreifenden Schnittstellen als wirksamste Strategie überhaupt. Die folgenden Schritte lassen sich in dieser Reihenfolge angehen:
- Zentrale Stammdaten definieren: ein System (z. B. Ihr ERP) wird zur führenden Quelle für Kunden, Artikel und Lieferanten.
- Schnittstellen zwischen bestehenden Programmen prüfen und, wo keine existieren, per API nachrüsten statt manuell zu importieren.
- Eingabevalidierung aktivieren, die vor dem Speichern prüft, ob ein Datensatz mit gleicher ID, Name oder Rechnungsnummer bereits existiert.
- Verantwortliche Person je Datendomäne (Kunden, Artikel, Rechnungen) benennen, auch wenn es nur eine Halbtagsrolle ist.
Die Entscheidungsregel für nicht-technische Verantwortliche lautet: Wenn ein Datensatz an mehr als einer Stelle von Hand eingegeben werden muss, ist das System falsch aufgesetzt, nicht der Mitarbeiter.
Wichtige Erkenntnisse
Doppelte Datenpflege lässt sich zuverlässig vermeiden, wenn eine zentrale Datenquelle, automatisierte Validierung vor dem Speichern und klare Verantwortlichkeiten zusammenwirken.
| Thema | Details |
|---|---|
| Zentrale Datenquelle einrichten | Ein System pro Datendomäne als Golden Record definieren, alle anderen ziehen sich Daten per Schnittstelle. |
| Validierung vor dem Speichern aktivieren | Fuzzy-Matching bei Neuanlage einbauen, damit ähnliche Datensätze vor dem Speichern erkannt werden. |
| Rechnungsprüfung nach Gewichtung | Bei Übereinstimmung von Rechnungsnummer, Kreditor und Betrag automatisch einen Klärfall auslösen. |
| Rollen und Verantwortung klären | Data Steward benennen, der Prüfregeln pflegt und unklare Treffer final entscheidet. |
| Passende Software nutzen | Tools wie ServiceLab bündeln Kunden-, Auftrags- und Rechnungsdaten von Anfang an in einer Struktur statt in getrennten Systemen. |
Inhaltsverzeichnis
- Doppelte Datenpflege vermeiden: Warum entstehen Dubletten überhaupt?
- Welche Kosten und Risiken verursachen doppelte Datensätze?
- Welche organisatorischen Regeln verhindern doppelte Datenpflege dauerhaft?
- Technische Maßnahmen und Architektur: Wie stoppen Sie doppelte Datenpflege im System?
- Wie erkennen Sie doppelte Rechnungen und Kundendaten zuverlässig?
- Wie wählen Sie die richtigen Werkzeuge gegen Datenredundanz aus?
- Wie hat ein Handwerksbetrieb doppelte Datenpflege konkret reduziert?
- Wie sieht ein realistischer Zeitplan für die Umsetzung aus?
- Was Entscheider bei doppelter Datenpflege oft unterschätzen
- ServiceLab: Zentrale Datenpflege statt drei Systeme parallel
- Quellen
Doppelte Datenpflege vermeiden: Warum entstehen Dubletten überhaupt?
Doppelte Datensätze entstehen fast immer an denselben drei Stellen, unabhängig von Branche oder Firmengröße. Insel-Systeme ohne Schnittstellen sind der häufigste Grund: Ein Handwerksbetrieb pflegt Kunden im Buchhaltungsprogramm, im Angebotstool und zusätzlich in einer Excel-Liste. Jede Neuanlage ist ein neuer Zufall.
Fehlende oder inkonsistente Primärschlüssel verschärfen das Problem. Wenn ein Kunde einmal mit „Müller GmbH“ und einmal mit „Müller GmbH & Co. KG“ angelegt wird, erkennt kein System automatisch, dass es sich um denselben Betrieb handelt, solange keine eindeutige ID dahinter steht. Auch Synchronisationsläufe ohne Prüfmechanik richten Schaden an: Ein nächtlicher Datenabgleich zwischen zwei Tools ohne Abgleichsschlüssel erzeugt bei jedem Lauf neue Kopien statt Aktualisierungen.
Dazu kommen strukturelle Ursachen:
- Medienbrüche durch manuelle Übertragung von Papier oder PDF in ein digitales System.
- Low-Code- oder No-Code-Prozesse, die schnell gebaut wurden, aber keine Dublettenprüfung enthalten.
- Unterschiedliche Datenformate zwischen Systemen (z. B. Datum, IBAN-Schreibweise, Telefonnummernformat), die einen eigentlich identischen Datensatz wie zwei verschiedene aussehen lassen.
In der Praxis entsteht ein Großteil des doppelten Erfassungsaufwands schlicht dadurch, dass Mitarbeiter Daten händisch in mehreren Programmen eintragen, weil diese nicht miteinander sprechen.
Profi-Tipp: *Prüfen Sie zuerst drei Stellen: Rechnungseingang und -ausgang, Kundenanlage im Vertrieb und den Artikelstamm im Einkauf.
Welche Kosten und Risiken verursachen doppelte Datensätze?
Doppelte Daten kosten Geld, und zwar direkter als viele glauben. Doppelzahlungen an Lieferanten sind das offensichtlichste Beispiel, aber längst nicht das teuerste Problem. Fehlerhafte Berichte, die auf doppelt gezählten Kunden oder Umsätzen basieren, führen zu Entscheidungen auf falscher Grundlage, oft unbemerkt über Monate.
Die Auswirkungen ziehen sich durch mehrere Kernprozesse:
- Im Purchase-to-Pay-Prozess führen doppelte Lieferantendatensätze zu falschen Zahlungsläufen und erschweren die Mahnwesen-Übersicht.
- In CRM-Prozessen verzerren doppelte Kundendatensätze die Kampagnenplanung und lassen Support-Historien auseinanderfallen.
- In der Lagerwirtschaft führen doppelte Artikelnummern zu falschen Bestandsmeldungen und in der Folge zu Fehlbestellungen.
Kurz eingeordnet: Unbeabsichtigte Datenredundanz treibt laut IBM nicht nur Speicher- und Betriebskosten nach oben, sondern verzerrt auch Analysen, weil dieselbe Information mehrfach in Auswertungen einfließt.
Diese Verzerrung ist der eigentliche stille Kostenfaktor. Ein Bericht, der zehn Kunden zählt, obwohl es nur acht sind, wirkt korrekt, führt aber zu falschen Kapazitätsplanungen. Genau deshalb brauchen Unternehmen nicht nur Vermeidung, sondern auch laufendes Monitoring und einen klaren Klärworkflow für die Fälle, die trotzdem durchrutschen.
Welche organisatorischen Regeln verhindern doppelte Datenpflege dauerhaft?
Technik allein reicht nicht. Ohne klare Regeln und Verantwortlichkeiten schleicht sich Redundanz innerhalb weniger Monate zurück, selbst in ein technisch perfekt aufgesetztes System. Data Governance ist deshalb kein Konzept für Großkonzerne, sondern eine Grundausstattung, die sich auch mit drei Mitarbeitern umsetzen lässt.
Ein funktionierendes Regelwerk braucht drei feste Bestandteile:
- Benennungsregeln: Ein einheitliches Schema für Kunden-, Artikel- und Lieferantennamen, das keine Interpretation zulässt (z. B. immer Rechtsform ausschreiben, keine Abkürzungen im Firmennamen).
- Pflichtfelder: Mindestens eine eindeutige Kennung pro Datensatz, die bei der Anlage nicht überspringbar ist, etwa Steuernummer, Kundennummer oder E-Mail-Adresse.
- Lebenszyklus-Definitionen: Klare Regeln, wann ein Kunde als „aktiv“, „inaktiv“ oder „zu prüfen“ markiert wird, damit alte Datensätze nicht parallel zu neuen weiterleben.
Wer diese Regeln durchsetzt, braucht auch jemanden, der sie hütet. Ein einfaches Rollenmodell reicht meist aus: ein Datenverantwortlicher (trifft Grundsatzentscheidungen), ein Data Steward (pflegt die Regeln im Alltag) und eine tägliche Pflegeverantwortliche Person je Team, die neue Datensätze vor der Anlage gegenprüft.
Für die Umsetzung hat sich eine kurze Checkliste bewährt:
- Single Source of Truth pro Datendomäne festlegen und dokumentieren.
- Golden-Record-Regel definieren: Welches System gewinnt bei Widersprüchen?
- Änderungsprozess für Stammdaten mit Freigabeschritt einführen, statt freie Bearbeitung für alle.
- Kurzschulung für alle, die neue Datensätze anlegen dürfen, inklusive der Frage „Wo suche ich zuerst, bevor ich etwas Neues anlege?“
Die Kombination aus Infrastruktur, Data Governance und regelmäßigen Audits schafft dabei die Transparenz, die reine Technik nicht liefern kann.
Technische Maßnahmen und Architektur: Wie stoppen Sie doppelte Datenpflege im System?
Die stärkste technische Waffe gegen doppelte Datenpflege ist ein Single Source of Truth, umgesetzt über Master Data Management und API-gesteuerte Synchronisation. Statt Daten in mehreren Systemen parallel zu pflegen, existiert ein Golden Record, und alle anderen Systeme ziehen sich die Information per Schnittstelle.
Vier Bausteine machen dieses Prinzip alltagstauglich:
- Validierung vor dem Schreiben: Server- oder schnittstellenseitige Prüfung, die bei jeder neuen Eingabe fragt, ob ein ähnlicher Datensatz existiert, bevor er gespeichert wird. Fuzzy-Matching (Ähnlichkeitsvergleich statt exakter Übereinstimmung) fängt dabei auch Tippfehler und Schreibvarianten ab.
- Datenbank-Normalisierung: Jede Information wird nur einmal gespeichert und über Primär- und Fremdschlüssel verknüpft, statt in mehreren Tabellen redundant abgelegt zu werden. Dieses Prinzip aus der relationalen Datenmodellierung) ist über 50 Jahre alt und trotzdem die Grundlage jeder soliden Datenbankarchitektur.
- ETL-Pipelines mit Deduplizierungsschritt: Beim Datenimport aus externen Quellen wird ein automatischer Abgleich eingebaut, der Dubletten vor dem Laden herausfiltert, statt sie erst nachträglich zu bereinigen.
- API statt Neuanlage: Updates laufen über sichere Schnittstellen (REST, OAuth), sodass ein bestehender Datensatz aktualisiert wird, statt versehentlich einen zweiten zu erzeugen.
Ein Beispiel aus der Praxis: Wer Produktinformationen zentral im ERP pflegt und per Schnittstelle an Webshop oder Marktplätze verteilt, muss nie wieder denselben Artikel in drei Systemen von Hand anlegen.
Bei der Architekturentscheidung zwischen Echtzeit-Checks und Batch-Deduplizierung gilt: Echtzeit-Prüfung verhindert Dubletten, bevor sie entstehen, braucht aber mehr Aufwand bei der Implementierung. Batch-Deduplizierung räumt regelmäßig auf, lässt aber zwischen den Läufen Dubletten temporär bestehen. Für Kundendaten und Rechnungen lohnt sich fast immer die Echtzeit-Variante.
Profi-Tipp: Fangen Sie mit Validierung vor dem Schreiben in genau einem System an, meist dem, in dem am meisten neu angelegt wird. Ein isolierter Erfolg zeigt dem Team schneller den Nutzen als ein großes Projekt, das erst nach Monaten wirkt.
Wie erkennen Sie doppelte Rechnungen und Kundendaten zuverlässig?
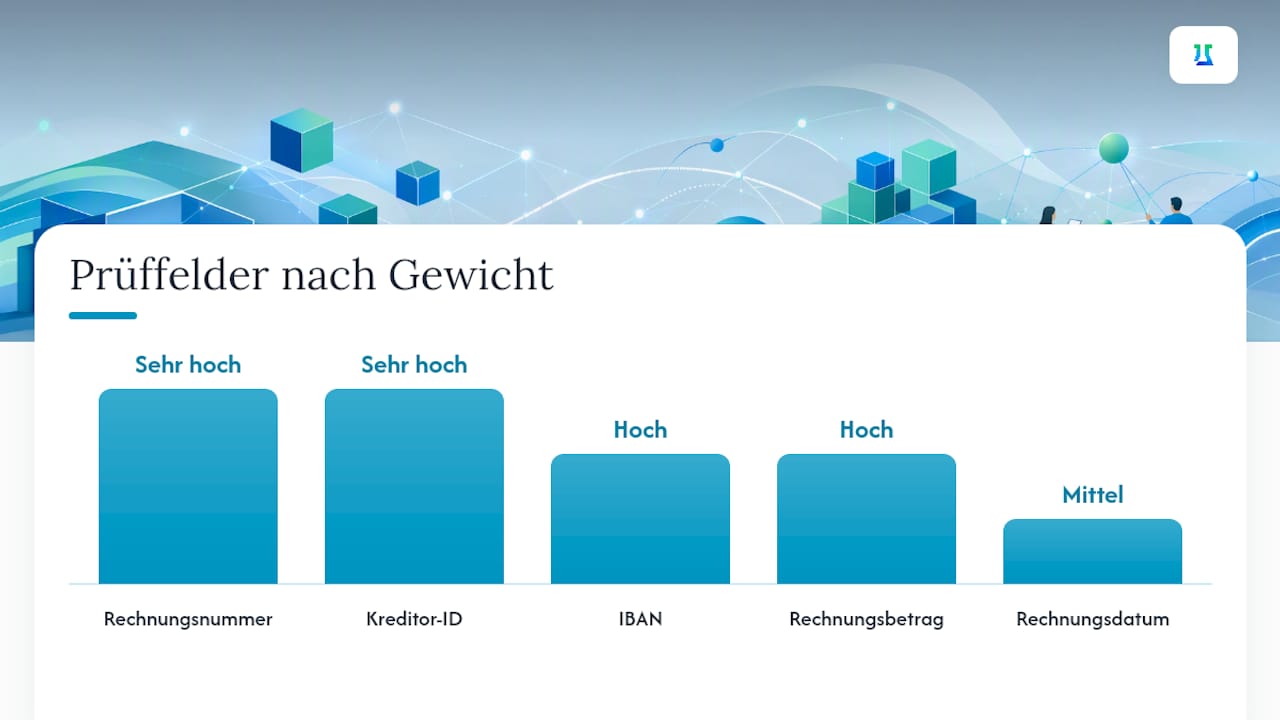
Doppelte Rechnungen lassen sich mit hoher Treffsicherheit erkennen, wenn mehrere Prüffelder gleichzeitig übereinstimmen, nicht nur eines. Stimmen drei oder mehr Felder überein, liegt mit hoher Wahrscheinlichkeit eine Dublette vor. Bei nur teilweiser Übereinstimmung sollte automatisch ein Klärfall entstehen, keine automatische Ablehnung.
| Prüffeld | Gewichtung | Empfehlung zur Toleranz |
|---|---|---|
| Rechnungsnummer | Sehr hoch | Exakte Übereinstimmung, keine Toleranz |
| Kreditor / Lieferanten-ID | Sehr hoch | Exakte Übereinstimmung über eindeutige ID, nicht über Freitextnamen |
| Rechnungsbetrag | Hoch | Exakte Übereinstimmung, minimale Rundungstoleranz möglich |
| Rechnungsdatum | Mittel | Toleranz von ein bis drei Tagen bei Systemverzögerung |
| PO-Nummer / Bestellreferenz | Mittel | Exakte Übereinstimmung, falls vorhanden |
| IBAN des Zahlungsempfängers | Hoch | Exakte Übereinstimmung, Warnung bei Abweichung trotz gleicher Rechnungsnummer |
Für Kundenstammdaten gilt ein ähnliches Prinzip, nur mit anderen Feldern. Eine eindeutige ID (Kundennummer, Steuernummer) hat immer Vorrang vor Namensvergleichen. Wo keine ID vorliegt, hilft die Kombination aus Name, Adresse und Fuzzy-Matching, ergänzt durch E-Mail-Adresse oder Telefonnummer als zweite Bestätigung. Ein Treffer bei Name plus Postleitzahl plus E-Mail-Domain reicht meist aus, um eine Dublette mit hoher Sicherheit zu markieren.
Nicht jeder Treffer ist eindeutig, und genau dafür braucht jedes System einen Fallback. Praktische Fallbacks wie Quarantäne oder manuelle Freigabe sind notwendig, weil sich nicht jede Ähnlichkeit automatisch zuordnen lässt. Ein Datensatz mit unklarem Treffer wandert in einen Klärstapel, statt automatisch angelegt oder automatisch verworfen zu werden. Wer Sammelrechnungen ausstellt, profitiert von dieser Logik besonders, weil dort mehrere Einzelpositionen zusammenlaufen und die Rechnungsprüfung entsprechend genauer hinsehen muss.
Profi-Tipp: Setzen Sie die Gewichtung für IBAN-Abweichungen bewusst hoch, auch wenn Rechnungsnummer und Betrag übereinstimmen. Ein Wechsel der Bankverbindung bei gleicher Rechnungsnummer ist ein klassisches Betrugsmuster, kein harmloser Zufall.
Wie wählen Sie die richtigen Werkzeuge gegen Datenredundanz aus?
Fünf Werkzeugkategorien lösen doppelte Datenpflege auf unterschiedlichen Ebenen: Master Data Management für die zentrale Stammdatenverwaltung, Integrationsplattformen für die Verbindung zwischen Systemen, ETL- beziehungsweise ELT-Werkzeuge für den Datenimport, spezialisierte Deduplizierungs-Module für den Ähnlichkeitsabgleich und Low-Code-Formulare mit eingebauter Validierung für die Erfassung an der Quelle. Für kleinere Betriebe reicht oft eine Kombination aus zwei dieser Kategorien, nicht alle fünf gleichzeitig.
Bei der Auswahl zählen fünf Kriterien wirklich:
- Echtzeitfähigkeit: Prüft das Tool bei der Eingabe oder erst im nächtlichen Batch?
- Fuzzy-Matching-Qualität: Erkennt es Tippfehler und Schreibvarianten oder nur exakte Duplikate?
- Skalierbarkeit: Wächst die Lösung mit steigender Datenmenge ohne Performanceverlust?
- Bedienbarkeit für kleine Teams: Braucht es einen IT-Spezialisten oder lässt es sich mit Grundkenntnissen konfigurieren?
- Sicherheit und Datenschutz: Wie und wo werden die Daten verarbeitet und gespeichert?
Vor einem Proof of Concept lohnen sich diese Fragen an jeden Anbieter:
- Wie lange dauert die Anbindung an unser bestehendes Buchhaltungs- oder ERP-System realistisch?
- Welche Datenformate werden nativ unterstützt, und was muss manuell konvertiert werden?
- Wie transparent ist die Fuzzy-Matching-Logik? Lässt sich die Gewichtung anpassen?
- Was kostet der Ausstieg, falls die Lösung nicht passt?
Genau die letzte Frage wird zu oft übersprungen. Die typischste Falle bei der Toolauswahl ist ein unterschätzter Integrationsaufwand, gefolgt von einem Lock-in-Effekt, wenn Stammdaten erst einmal tief in einem proprietären Format liegen. Wer sich technisch tiefer mit Datenbankstrukturen beschäftigen will, findet in kostenlosen SQL-Übungen einen guten Einstieg, um Validierungsabfragen später selbst nachvollziehen zu können.
Wie hat ein Handwerksbetrieb doppelte Datenpflege konkret reduziert?
Ein Beispiel aus dem Handwerksalltag zeigt, wie wenig Aufwand ein erster Schritt tatsächlich braucht. Ein Elektrobetrieb mit acht Mitarbeitern arbeitete mit drei getrennten Systemen: einer Buchhaltungssoftware, einem Angebotstool und einer Excel-Liste für Kundendaten. Jeder neue Auftrag bedeutete bis zu drei manuelle Eingaben derselben Kundendaten, und Tippfehler sorgten regelmäßig für doppelte Kundennummern.
Das Pilotprojekt lief in vier klar abgegrenzten Schritten:
- Ein Golden Record für Kundendaten wurde im Buchhaltungssystem definiert, das ab sofort als führende Quelle galt.
- Eine API-Anbindung zwischen Buchhaltung und Angebotstool ersetzte die Excel-Liste komplett.
- Eine Echtzeitvalidierung prüfte bei jeder Neuanlage automatisch auf ähnliche Namen, Adressen und Telefonnummern.
- Alle Mitarbeiter erhielten eine kurze Einweisung, wie ein Klärfall bei einem unsicheren Treffer zu behandeln ist.
Nach drei Monaten zeigte sich der Effekt vor allem an zwei Stellen: deutlich weniger Klärfälle bei der monatlichen Rechnungsprüfung und spürbar weniger Zeitaufwand bei der Kundenanlage, weil niemand mehr dieselbe Adresse dreimal eintippen musste. Wer digitale Stundenzettel und Nachkalkulation direkt im ERP mitlaufen lässt, verhindert genau diese Art von paralleler Datenpflege von Anfang an.
Für ein eigenes KMU-Pilotprojekt reichen drei konkrete Aufgabenblöcke: technisch die Schnittstelle zwischen den zwei wichtigsten Systemen bauen, organisatorisch eine verantwortliche Person für den Golden Record benennen, und im Team eine einstündige Schulung zum neuen Klärprozess durchführen.
Wie sieht ein realistischer Zeitplan für die Umsetzung aus?
Ein Pilotprojekt gegen doppelte Datenpflege lässt sich in vier Phasen strukturieren, die aufeinander aufbauen, statt parallel zu laufen.
- Analyse (1 bis 2 Wochen): Bestehende Systeme, Datenflüsse und aktuelle Dublettenrate erfassen. Deliverable: eine Liste der drei größten Redundanzquellen.
- Pilot (4 bis 8 Wochen): Ein System als Golden Record definieren, eine Schnittstelle bauen, Validierung in einem Teilbereich aktivieren. Deliverable: funktionierende API-Verbindung mit messbarer Dublettenrate.
- Iteration (2 bis 4 Wochen): Fuzzy-Matching-Regeln anhand echter Klärfälle nachschärfen, Fallback-Workflow verfeinern. Deliverable: dokumentierte Prüfregeln mit Gewichtung.
- Rollout (variabel, meist 4 bis 12 Wochen): Ausweitung auf weitere Abteilungen oder Systeme, Schulung aller Beteiligten. Deliverable: unternehmensweiter Governance-Leitfaden.
Für dieses Vorgehen braucht es keine große Projektmannschaft, aber klare Rollen:
- Ein Projektleiter, der Fortschritt und Budget verantwortet.
- Ein Data Steward, der die Prüfregeln pflegt und Klärfälle final entscheidet.
- Eine Entwicklerin oder ein externer Dienstleister für die Schnittstellenarbeit.
- Ein Fachbereichsvertreter, meist aus Vertrieb oder Buchhaltung, der die Praxistauglichkeit prüft.
Der Erfolg lässt sich an drei Kennzahlen ablesen: der Anzahl offener Klärfälle pro Monat, der Dublettenrate im Kundenstamm (Anteil erkannter Duplikate an der Gesamtzahl der Datensätze) und dem Zeitaufwand für die monatliche Rechnungsprüfung im Vergleich zum Ausgangswert vor dem Projekt.
Was Entscheider bei doppelter Datenpflege oft unterschätzen
Die meisten Betriebe, mit denen ich über Datenqualität spreche, denken bei doppelter Datenpflege zuerst an ein IT-Problem. Das ist der falsche Ausgangspunkt. Das eigentliche Problem ist fast immer ein fehlender Besitzanspruch: Niemand fühlt sich für den Kundenstamm oder den Artikelstamm richtig verantwortlich, also pflegt jeder ein bisschen, und am Ende pflegt niemand konsequent.
Was ich für den größten blinden Fleck halte: Unternehmen bauen oft eine technisch saubere Lösung, vergessen aber, dass Datenqualität keine einmalige Aufgabe ist, sondern eine laufende Managementaufgabe, die genauso wenig „fertig“ wird wie Buchhaltung oder Lagerpflege. Ein Golden Record, der heute perfekt ist, verwässert innerhalb eines Jahres wieder, wenn niemand die Regeln nachschärft oder neue Mitarbeiter einweist.
Meine Priorisierungsempfehlung für Entscheider ist deshalb unpopulär, aber ehrlich: Fangen Sie nicht mit dem größten System an, sondern mit dem, in dem am häufigsten neue Datensätze entstehen. Meist ist das die Kundenanlage im Vertrieb oder die Rechnungserfassung, nicht das komplexe ERP-Kernsystem. Kleine, sichtbare Erfolge dort schaffen die Akzeptanz, die man für größere Integrationsprojekte später braucht. Werkzeuge wie ServiceLab können genau an dieser Stelle helfen, weil sie Auftrag, Kunde und Rechnung von Anfang an in einer zentralen Struktur führen, statt Datenpflege auf mehrere Insel-Systeme zu verteilen.
ServiceLab: Zentrale Datenpflege statt drei Systeme parallel
Alles, was in diesem Artikel als Lösung beschrieben wird, zentraler Stammsatz, automatische Rechnungszuordnung und Validierung vor der Neuanlage, ist bei ServiceLab bereits eingebaut, statt als separates Projekt geplant werden zu müssen.
ServiceLab führt Kunden-, Auftrags- und Rechnungsdaten in einer einzigen Struktur auf dem iPad und im Web, sodass ein Kunde nicht in einem Angebotstool, einem Buchhaltungsprogramm und einer Excel-Liste parallel existiert. Die App erstellt Rechnungen automatisch aus abgeschlossenen Aufträgen, inklusive ZUGFeRD-konformer E-Rechnung, und verknüpft sie direkt mit dem hinterlegten Kundenstamm, statt neue Datensätze zu erzeugen. Auch bei Offline-Arbeiten auf der Baustelle bleibt die Datenbasis konsistent, weil ServiceLab beim nächsten Synchronisationslauf gegen den bestehenden Datensatz prüft, nicht blind neu anlegt. Die Speicherung erfolgt DSGVO-konform, die Bedienung ist auf iPad-Nutzung im Arbeitsalltag von Handwerksbetrieben zugeschnitten.
Wer als Kleinunternehmen mit ein bis fünfzehn Mitarbeitern genug von doppelter Dateneingabe hat, kann ServiceLab kostenlos testen und in wenigen Minuten sehen, wie sich Auftrag, Unterschrift und Rechnung ohne zweiten Eintrag verbinden lassen.
Quellen
Wer tiefer in einzelne Themen einsteigen will, findet bei folgenden Quellen konkrete Anschlussinformationen: