
Offline First bedeutet: Die App liest und schreibt zuerst gegen eine lokale Datenquelle wie SQLite oder IndexedDB und synchronisiert erst danach mit dem Server. Das lohnt sich, sobald Nutzer im Außendienst, bei Inventuren oder im Kundenkontakt ohne stabiles Netz arbeiten müssen. Für reine Bürosoftware mit Dauerverbindung ist der Mehraufwand meist unnötig.
Kurz gesagt:
- Offline First ist sinnvoll für Anwendungen, deren Nutzer regelmäßig ohne stabiles Internet arbeiten, wie im Außendienst oder bei Inventuren.
- Die Architektur basiert auf localer Datenquelle, Repository, Outbox und Sync-Engine, um Daten zuverlässig zu synchronisieren und Konflikte zu lösen.
- Bei Schreibvorgängen ist eine Strategie wie Last Write Wins meist ausreichend, während komplexe Methoden wie CRDTs eher für Echtzeit-Kollaboration geeignet sind.
- Für Browser empfiehlt sich die Nutzung von Service Workern, IndexedDB und Background Sync, auf mobilen Geräten vor allem SQLite und plattformübergreifende Bibliotheken.
- Der Mehraufwand für Offline-First-Architektur liegt bei 15 bis 25 Prozent, lohnt sich aber vor allem bei kritischer offline Nutzung oder hohem Datenverlustrisiko.
Inhaltsverzeichnis
- Was ist Offline First? Abgrenzung zu Online First und Offline Capable
- Aus welchen Bausteinen besteht eine Offline-First-Architektur?
- Wie funktionieren Lese- und Schreibstrategien offline?
- Pull oder Push: Wie sollte Synchronisation ablaufen?
- Welche Speichertechnologien passen zu Web und Mobile?
- Wann lohnt sich Offline First und wann ist es Overkill?
- Wie sieht eine Implementierungs-Checkliste für Offline-First-Apps aus?
- AppLaboratory: Praxis-Perspektive aus KMU-Projekten
- ServiceLab: Offline-Funktionen für den Handwerksalltag
- Quellen
- FAQ
Was ist Offline First? Abgrenzung zu Online First und Offline Capable
Die drei Begriffe werden ständig verwechselt, meinen aber unterschiedliche Architekturentscheidungen.
Online First heißt: Die App braucht eine Netzwerkverbindung, um überhaupt zu funktionieren. Fällt das Netz weg, zeigt sie einen Fehler oder einen Ladebildschirm. Klassisches Beispiel ist eine simple Web-Anwendung, die jede Anfrage direkt an die API schickt.
Offline Capable bedeutet, eine App verträgt kurze Aussetzer, etwa durch Caching einzelner Antworten. Sie bleibt aber im Kern netzabhängig. Fehlt die Verbindung länger, brechen Funktionen weg.
Offline First dreht das Prinzip um. Die lokale Datenquelle gilt als kanonische Quelle der Wahrheit, wie es die Android-Dokumentation formuliert. Lesevorgänge müssen ohne Netzwerk funktionieren, Schreibvorgänge landen zunächst lokal und werden erst danach synchronisiert.
Die Entscheidung, welches Modell passt, hängt an drei Fragen:
- Muss die Kernfunktion auch ohne Netz nutzbar sein, oder reicht eine Fehlermeldung?
- Wie lange und wie oft sind Nutzer tatsächlich offline (Sekunden im Tunnel oder Stunden auf der Baustelle)?
- Wie kritisch ist Datenverlust bei einem Absturz mitten in der Eingabe?
Wer alle drei Fragen mit "kritisch" beantwortet, landet bei Offline First. Alles andere ist meist mit Caching und ein paar Retry-Mechanismen erledigt.
Aus welchen Bausteinen besteht eine Offline-First-Architektur?
Eine Offline-First-Architektur besteht im Kern aus vier Teilen, die zusammen einen sauberen Datenfluss bilden: lokale Datenquelle, Netzwerkdatenquelle, Repository und Sync-Engine.
Die lokale Datenquelle ist der Ausgangspunkt jeder Leseoperation. Auf Mobilgeräten ist das meist SQLite oder eine Abstraktion darüber, im Browser IndexedDB. Die App fragt niemals direkt das Netzwerk für eine Anzeige an, sondern liest aus der lokalen Datenbank.
Das Repository verbindet lokale und entfernte Quelle. Es entscheidet, wann aus dem Cache gelesen wird und wann eine Netzwerkanfrage im Hintergrund läuft, um die lokale Kopie zu aktualisieren. Flutters Architekturleitfaden beschreibt genau dieses Muster: Ein Repository liefert über einen Stream zuerst den lokalen Wert aus und schiebt den aktualisierten Netzwerkwert nach, sobald er verfügbar ist.
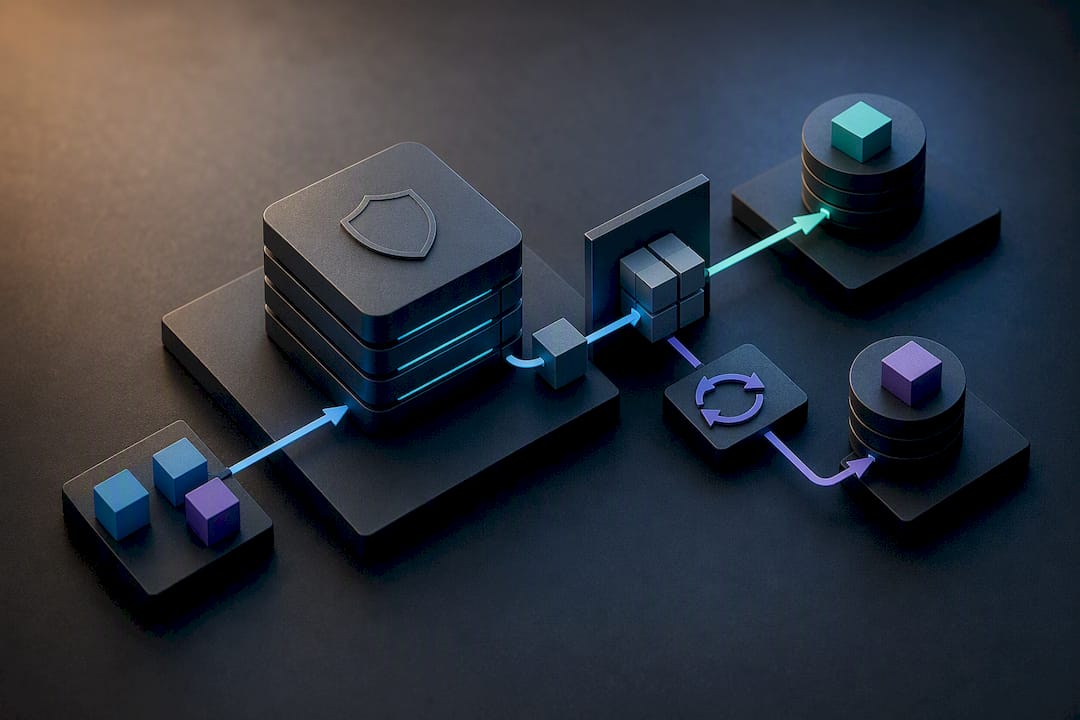
Die Outbox (auch Queue genannt) sammelt Schreibvorgänge, die noch nicht synchronisiert sind. Jeder lokale Schreibvorgang erzeugt einen Eintrag mit Zeitstempel, Operation und Payload. Die Sync-Engine arbeitet diese Warteschlange ab, sobald eine Verbindung besteht.
Die Sync-Engine selbst kümmert sich um Versionierung, Konfliktprüfung und die eigentliche Übertragung. Ein konkretes Beispiel für dieses Zusammenspiel zeigt das Offline-Sync-Engine-Projekt auf GitHub, das Outbox-Pattern, inkrementelle Syncs und Bandbreitenoptimierung kombiniert.
| Komponente | Aufgabe | Typische Umsetzung |
|---|---|---|
| Lokale Datenquelle | Primäre Quelle für Lesevorgänge | SQLite, IndexedDB, Realm |
| Netzwerkdatenquelle | Liefert Serverstand nach | REST-API, GraphQL, WebSocket |
| Repository | Vermittelt zwischen lokal und remote | Kotlin Flow, Dart Stream, RxJS |
| Outbox/Queue | Speichert ausstehende Schreibvorgänge | Lokale Tabelle mit Status-Feld |
| Sync-Engine | Führt Konfliktprüfung und Übertragung aus | Eigene Engine oder Library |
Beim App-Start liest die App zuerst aus der lokalen Datenbank, zeigt sofort etwas an und stößt parallel einen Hintergrundabgleich an. Das hält die Wartezeit für Nutzer bei null, unabhängig vom Netzstatus.
Wie funktionieren Lese- und Schreibstrategien offline?
Lesevorgänge in einer Offline-First-App laufen reaktiv. Statt einer einmaligen Anfrage abonniert die Oberfläche einen Stream oder Flow, der bei jeder Änderung der lokalen Datenbank neu auslöst. Das Repository schreibt neue Serverdaten einfach in die lokale Datenbank, und die Oberfläche aktualisiert sich automatisch, ganz ohne manuelles Nachladen.
Bei Schreibvorgängen gibt es zwei grundsätzliche Strategien.
Online-First-Writes senden die Änderung sofort an den Server und aktualisieren die lokale Kopie erst nach Bestätigung. Das ist einfacher zu implementieren, blockiert aber die Bedienung, sobald das Netz fehlt.
Offline-First-Writes schreiben zuerst lokal, zeigen die Änderung sofort an und legen den Vorgang in die Outbox. Das fühlt sich für Nutzer schneller an, verlangt aber eine klare Fehlerbehandlung, falls der Sync später scheitert.
Die praktikablen Muster dafür:
- Jeder Schreibvorgang erhält eine eindeutige Client-ID, damit doppelte Übertragungen erkannt werden.
- Fehlgeschlagene Syncs landen in einer Retry-Schleife mit exponentiellem Backoff, meist startend bei ein bis zwei Sekunden.
- Die Oberfläche zeigt den Sync-Status pro Datensatz an (ausstehend, synchronisiert, fehlgeschlagen), nicht nur global.
- Nach einer bestimmten Anzahl gescheiterter Versuche wandert der Eintrag in eine manuelle Fehlerliste statt endlos weiterzuversuchen.
Profi-Tipp: Zeigen Sie niemals nur einen globalen „Offline“-Indikator. Nutzer wollen wissen, ob genau ihre letzte Eingabe schon gesichert ist, nicht nur den allgemeinen Netzwerkstatus der App.
Pull oder Push: Wie sollte Synchronisation ablaufen?
Zwei Grundmuster stehen zur Wahl, und die meisten Apps kombinieren beide.
Pull-Sync fragt in Intervallen oder bei App-Start aktiv nach Änderungen. Das ist einfach umzusetzen, verursacht aber unnötigen Datenverkehr, wenn nichts Neues vorliegt.
Push-Sync informiert den Client über Server-Events, etwa via WebSocket oder Push-Benachrichtigung, sobald sich etwas ändert. Das ist reaktionsschneller, braucht aber mehr Serverinfrastruktur.
Für die Bandbreite entscheidend ist inkrementelle Synchronisation: Statt jedes Mal den vollständigen Datensatz zu übertragen, sendet der Client nur Änderungen seit dem letzten erfolgreichen Sync-Zeitpunkt. Techniken wie Delta-Kompression können das übertragene Volumen deutlich senken, wie Beispielimplementierungen im Offline-Sync-Engine-Repository zeigen.
Bei Konflikten, wenn zwei Geräte denselben Datensatz offline geändert haben, gibt es vier gängige Strategien:
- Last Write Wins (LWW): Der Eintrag mit dem neueren Zeitstempel gewinnt. Einfach, aber es können stille Datenverluste entstehen.
- Manuelle Auflösung: Der Nutzer bekommt beide Versionen angezeigt und entscheidet selbst. Sinnvoll bei geschäftskritischen Feldern wie Preisen.
- CRDTs (Conflict-free Replicated Data Types): Datenstrukturen, die sich automatisch und deterministisch zusammenführen lassen, wie es Projekte wie TopGun für Echtzeit-Kollaboration demonstrieren.
- Operational Transformation (OT): Transformiert konkurrierende Operationen so, dass sie in beliebiger Reihenfolge angewendet dasselbe Ergebnis liefern, meist bei Texteditoren im Einsatz.
Für die überwiegende Mehrheit an Business-Apps reicht eine einfache LWW-Strategie mit Zeitstempeln aus, während CRDTs und OT eher Spezialfälle für echte Realtime-Kollaboration sind, etwa bei gemeinsamen Dokumenten oder Whiteboards. Wer eine Auftragsverwaltung oder ein Warenwirtschaftssystem für KMU baut, kommt fast immer mit LWW plus gelegentlicher manueller Prüfung bei kritischen Feldern aus, ganz ohne die Komplexität von CRDTs.
Robustheit entsteht zusätzlich durch idempotente APIs (ein zweimal gesendeter Request darf keinen doppelten Datensatz erzeugen), resumable Uploads für große Dateien und einen klar sichtbaren Sync-Status pro Objekt.
Welche Speichertechnologien passen zu Web und Mobile?
Die Wahl der Speichertechnologie hängt stark von der Plattform ab, und hier lohnt sich kein Universalansatz.
Im Browser bildet der Service Worker das Rückgrat. Er fängt Netzwerkanfragen ab und liefert Antworten aus dem Cache, bevor überhaupt eine Anfrage das Gerät verlässt. MDN beschreibt drei zentrale Caching-Strategien: Cache-First für statische Assets, Network-First für häufig wechselnde Inhalte und Stale-While-Revalidate als Kompromiss, der sofort den Cache liefert und im Hintergrund aktualisiert. Für strukturierte Daten kommt IndexedDB zum Einsatz, ergänzt durch die Background-Sync-API für aufgeschobene Schreibvorgänge. Deren Browser-Unterstützung ist allerdings uneinheitlich: Chromium-Browser decken sie gut ab, Safari nur eingeschränkt.
Auf mobilen Plattformen dominiert SQLite als Basis, oft über Abstraktionsschichten wie Room (Android) oder Core Data (iOS). Für plattformübergreifende Projekte haben sich Bibliotheken wie PouchDB, RxDB, WatermelonDB und Realm etabliert, ergänzt durch Couchbase Lite für Unternehmenslösungen mit eingebauter Replikation.
Ein Punkt, der oft zu kurz kommt: Datenschutz beginnt schon bei der lokalen Speicherung, nicht erst bei der Übertragung. Wer sensible Kundendaten offline hält, sollte auf verschlüsselte Datenbanken setzen und Schlüssel niemals im Klartext im Dateisystem ablegen. Eine transparente Sync-Oberfläche, die zeigt, was wann synchronisiert wurde, gehört ebenso zu einer durchdachten Offline-First-Architektur unter Datenschutzaspekten.
- Browser: Service Worker plus IndexedDB, ergänzt durch Background Sync wo unterstützt.
- iOS/Android nativ: SQLite direkt oder über Room/Core Data.
- Plattformübergreifend: RxDB, WatermelonDB oder Realm je nach Framework.
- Enterprise mit Replikationsbedarf: Couchbase Lite.
Wann lohnt sich Offline First und wann ist es Overkill?
Offline First zahlt sich bei Field Service Management aus, also bei Anwendungen für Außendienst, Wartungstechniker oder Handwerksbetriebe, die vor Ort beim Kunden ohne WLAN arbeiten. Auch Inventursoftware, Notiz-Apps und CRM-Systeme mit Vor-Ort-Erfassung profitieren stark, weil jede Downtime direkt Umsatz oder Datenqualität kostet.
Der Aufwand ist real: Eine Offline-First-Architektur bringt gegenüber einer reinen Online-Lösung rund 15 bis 25 Prozent zusätzlichen Entwicklungsaufwand mit sich, vor allem wegen Konfliktlösung, Sync-Logik und zusätzlicher Testfälle. Dieser Mehraufwand rechnet sich aber schnell, wenn Nutzer sonst regelmäßig blockiert wären.
Overkill ist Offline First bei internen Admin-Dashboards mit Dauerverbindung, bei Apps mit vernachlässigbarer Offline-Nutzung oder wenn ein einfaches Caching für kurze Netzaussetzer schon ausreicht. Der Entscheidungsfaktor ist nicht die Technik-Faszination, sondern die tatsächliche Nutzungssituation:
- Nutzer arbeiten regelmäßig ohne stabiles Netz (Baustelle, Keller, ländliche Gebiete): Offline First lohnt sich.
- Datenverlust bei Verbindungsabbruch wäre geschäftskritisch: Offline First lohnt sich.
- Die App läuft ausschließlich im Büro mit Firmennetz: Caching reicht meist aus.
- Das Team hat keine Erfahrung mit Sync-Konflikten und knappe Zeit: Erst ein einfaches Caching-Modell bauen, Offline First später nachrüsten.
Wie sieht eine Implementierungs-Checkliste für Offline-First-Apps aus?
Bevor der erste Code entsteht, braucht es drei Grundsatzentscheidungen: das Datenmodell (welche Entitäten offline gehalten werden), die Konfliktstrategie (LWW reicht fast immer) und das Sync-Fenster (wie oft und unter welchen Bedingungen synchronisiert wird).
Danach folgt die technische Umsetzung in einer sinnvollen Reihenfolge:
- Lokale Datenbank aufsetzen und Schema definieren, inklusive Versionierungsfeldern für spätere Migrationen.
- Repository-Schicht bauen, die Lese-Streams aus der lokalen Quelle bedient.
- Outbox-Tabelle für ausstehende Schreibvorgänge implementieren, inklusive Client-ID und Zeitstempel.
- Sync-Engine mit Retry-Logik und exponentiellem Backoff entwickeln oder eine bestehende Lösung integrieren.
- Sync-Status sichtbar in der Oberfläche einbauen, pro Datensatz und nicht nur global.
- Migrationsplan für Schema-Änderungen schreiben, bevor die erste Version live geht.
Profi-Tipp: Bauen Sie den Migrationsplan nicht erst nach dem ersten Update. Jede Schema-Änderung an der lokalen Datenbank muss auch für Geräte funktionieren, die seit Monaten offline waren und noch die alte Version im Cache haben.
Beim Testen zählen vor allem die Grenzfälle, die im Normalbetrieb selten auffallen: Was passiert, wenn die Verbindung mitten im Sync abbricht? Bleibt die App bedienbar, wenn die lokale Datenbank mehrere Tausend ausstehende Einträge enthält? Wird ein doppelt gesendeter Request korrekt als solcher erkannt? Und wie reagiert die Oberfläche, wenn ein Sync dauerhaft fehlschlägt, etwa wegen eines Serverfehlers? Diese vier Szenarien decken die meisten Produktionsprobleme ab, die in Offline-First-Apps auftreten.
AppLaboratory: Praxis-Perspektive aus KMU-Projekten
Wer Software für Handwerksbetriebe baut, merkt schnell: Die Theorie zu CRDTs interessiert niemanden auf der Baustelle. Was zählt, ist, dass der Auftragszettel gespeichert bleibt, wenn im Keller kein Netz ist, und dass die Rechnung trotzdem korrekt rausgeht, sobald wieder Verbindung besteht.
Bei ServiceLab, der ERP-App von AppLaboratory für Kleinunternehmen, spiegelt sich genau diese Pragmatik in den Grundentscheidungen wider. Auftragserfassung und die Unterschrift des Kunden vor Ort müssen ohne Wackelkontakt zum Internet funktionieren, denn genau dort, wo Handwerker arbeiten, ist das Netz oft am schlechtesten.
Die Lektion aus solchen Projekten deckt sich mit der technischen Empfehlung weiter oben: Eine einfache, nachvollziehbare Konfliktstrategie schlägt eine elegante, aber komplexe fast immer. Wichtiger als die Wahl zwischen LWW und CRDT ist, dass Nutzer jederzeit sehen, ob ihr Auftrag schon gesichert ist. Und der Migrationsplan gehört von Tag eins an ins Projekt, nicht als nachträgliche Reparatur.
— Sandro Moebius
ServiceLab: Offline-Funktionen für den Handwerksalltag
Statt eine eigene Offline-First-Architektur von Grund auf zu bauen, was die 15 bis 25 Prozent Mehraufwand aus dem Abschnitt oben tatsächlich real macht, können Handwerksbetriebe direkt auf eine bestehende Lösung setzen.
ServiceLab von AppLaboratory unterstützt Offline-Arbeiten bei den Kernfunktionen, die im Alltag zählen: digitale Auftragserfassung, Vor-Ort-Unterschrift des Kunden und automatische Rechnungserstellung inklusive ZUGFeRD-konformer E-Rechnungen. Das läuft auf mobilen Geräten und im Web, ganz ohne dass ein Techniker auf der Baustelle auf Netzsuche gehen muss. Sobald die Verbindung wieder da ist, gehen Aufträge, Unterschriften und Rechnungen automatisch nach der Unterschrift raus, ohne dass jemand manuell nachfassen muss.
Wer wissen will, wie sich das im eigenen Betrieb anfühlt, kann sich die ServiceLab-Produktseite ansehen und die App unverbindlich testen.
Quellen
- Offline‑orientierte App erstellen | App architecture
- Offline‑first architecture | Flutter Docs
- Offline‑First Apps: Architecture, Frameworks & Real Examples
- iannil/offline-sync-engine
- Progressive Web Apps (MDN)
FAQ
Was bedeutet Offline First genau?
Offline First heißt, dass eine App zuerst gegen eine lokale Datenquelle liest und schreibt und erst danach mit dem Server synchronisiert, statt bei jeder Aktion auf das Netzwerk zu warten.
Ist Offline an oder aus, wenn eine App im Offline-Modus läuft?
Der Offline-Modus einer Offline-First-App ist technisch immer "an", weil die App grundsätzlich gegen die lokale Datenbank arbeitet. Die Netzwerkverbindung ist nur ein zusätzlicher Kanal, der Daten im Hintergrund synchronisiert, sobald sie verfügbar ist.
Was passiert, wenn keine Internetverbindung besteht?
In einer Offline-First-App bleiben Lesen und Schreiben voll funktionsfähig, weil beides gegen die lokale Datenbank läuft. Schreibvorgänge landen in der Outbox und werden automatisch übertragen, sobald wieder eine Verbindung besteht.
Wieso zeigt meine App manchmal den Offline-Modus an, obwohl WLAN aktiv ist?
Das passiert meist, wenn die App eine Serverantwort nicht innerhalb eines Timeouts erhält, etwa bei einer instabilen Verbindung oder einem kurzzeitig nicht erreichbaren Server, und deshalb vorsorglich auf lokale Daten zurückgreift.
Lohnt sich Offline First für ein kleines Warenwirtschaftssystem im Handwerk?
Ja, sobald Aufträge, Lagerbestand oder Rechnungen auch unterwegs oder auf der Baustelle erfasst werden müssen. Für ein rein bürogebundenes System mit Dauerverbindung reicht dagegen oft einfaches Caching aus.
Reicht Last Write Wins als Konfliktstrategie aus?
Für die meisten Business-Apps wie Auftragsverwaltungen oder CRM-Systeme reicht Last Write Wins mit Zeitstempeln aus. CRDTs oder Operational Transformation lohnen sich fast nur bei echter Echtzeit-Kollaboration mehrerer Nutzer am selben Datensatz.